
工業 AI|技術架構
結合 NVIDIA 的工業數位孿生與物理 AI 基礎,把製造 know-how、機器學習、代理式 AI 與治理帶進同一套決策與執行流程
工業數位孿生描述實體狀態與可能結果;Profet AI Domain Twin™ 則加入製造知識、模型證據、權限與工作流程,讓企業把實體證據轉成受治理的行動,並沉澱為可複用的營運能力。
架構前提
在本文架構中,工業數位孿生提供可計算的實體營運環境;Domain Twin™ 則讓製造企業特有的知識、模型證據、決策權與治理條件成為 AI 可使用的營運脈絡。
製造業投入數位孿生已經多年。從工廠配置、產線設備到產品與製程,企業一直在建立更完整的數位表示。近年這套能力開始與物理 AI 匯流:NVIDIA 將工業數位孿生延伸到設計、模擬、營運與最佳化;NVIDIA Omniverse™ 函式庫與 OpenUSD 則提供資料互通、物理與感測器模擬等基礎,讓機器人與自主系統能在部署前先完成測試與驗證。
這讓許多過去只能在現場試錯的工程問題,可以先在虛擬環境裡驗證。產線目前發生什麼、配置改變後物料流如何變化、機器人在特定環境中會如何運作,以及不同條件下的產能與能耗,都能先被觀察、模擬與評估。真正進入工廠營運後,難題很快從「看見什麼」轉成「接下來怎麼做」。同一個設備異常,下一步可能取決於製程配方版本、當前批次、維修履歷、現行 SOP、模型的有效範圍、工程師判斷,以及系統或 AI 代理是否具備執行權限。
Domain Twin™ 承接的正是這一段企業決策。它把製造企業累積的 know-how、模型證據、決策規則、權限與工作流程放進同一個可治理的決策環境,讓設備狀態與模擬結果能依照企業真正的運作方式被解讀、判斷與執行,而不是停留在孤立的訊號、文件或模型輸出。
兩種 Twin,解的是不同層次的問題
在本文的架構裡,數位孿生負責描述實體環境正在發生什麼,以及在物理限制下可能發生什麼;Domain Twin™ 則處理企業如何解讀這些證據、依據哪些知識與規則做判斷,以及下一步由誰負責。兩者不是替代關係,而是把「實體世界的狀態」與「企業的決策方式」接在一起。
| 比較面向 | 工業數位孿生/實體世界脈絡 | Domain Twin™/企業決策脈絡 |
|---|---|---|
| 建模對象 | 實體狀態、空間幾何、運轉條件與物理限制。 | 企業知識、工程經驗、AI/AutoML 模型、SOP、權限與決策規則。 |
| 典型輸入 | 設備狀態、感測器資料、製程條件、模擬結果與物理限制。 | 工程 know-how、歷史案例、品質資料、模型輸出、政策、權限與工作流程。 |
| 可回答的問題 | 現在發生什麼?如果改變配置、製程或機器人行為,物理結果會怎麼變? | 依照這家公司的知識與規則,現在該查什麼、做什麼、誰可以核准? |
| 在閉環中的作用 | 把工廠變成可觀察、可模擬、可驗證的工程環境。 | 把企業如何判斷與行動的方式變成 AI 可調用、可治理的決策能力。 |
表 1|數位孿生與 Domain Twin™ 在同一個工業 AI 閉環中承接不同層次的資訊。這是架構責任的區分,不代表數位孿生的功能只限於模擬;NVIDIA 的工業數位孿生同樣延伸到營運與最佳化。
Domain Twin™ 真正要複製的,是企業的判斷方式
製造知識很少完整存在同一個地方。它可能在資深工程師的經驗裡,也可能散落在 SOP、異常處理紀錄、製程參數、維修履歷、品質報告與工程文件中;企業多年累積的 AI 與機器學習模型,也往往只適用特定產品、設備家族或操作條件。
更關鍵的是這些資訊之間的判斷方法:異常發生時先查什麼?哪些歷史案例真正可比?模型輸出在什麼條件下足以支撐建議?哪些動作一定要人工核准?哪一位工程師、哪個系統或哪個 AI 代理有權往下一步走?這些問題,才決定一套 know-how 能不能被安全地複製。
Domain Twin™ 把這些分散的 know-how 組成 AI 可使用、企業也能持續治理的決策環境。人員、流程、知識與資料共同構成企業情境,支撐理解、推理、決策、治理與行動五類核心能力;工程經驗、SOP、歷史案例、AI/AutoML 模型、品質證據與決策邏輯,則成為可被調用的企業知識與決策資產。
產品層仍是 Domain Twin™。其中,AutoML 提供機器學習能力,把結構化製造資料轉成預測、異常偵測與最佳化模型;AI Studio 則提供代理式 AI 能力,負責編排 AI 代理,串接 Model Hub(模型中心)、Knowledge/RAG、Tools/MCP、Memory、Guardrails、ACL/ABAC 與 Audit。AI 代理因此能在同一個治理框架下檢索核准知識、調用模型與工具、比對歷史案例,再把判斷帶進企業工作流程。
RAG 能找到一份 SOP,卻不會自動知道這份 SOP 是否適用目前的製程配方,也不會判斷某個模型是否適用這一批次,更不會替企業決定目前的 AI 代理有沒有權限執行。Domain Twin™ 要保留下來的,是知識、模型、情境與權責之間的關係,讓每一次判斷都有來源、有適用範圍,也有清楚的行動邊界。
參考架構:讓實體訊號進入企業決策
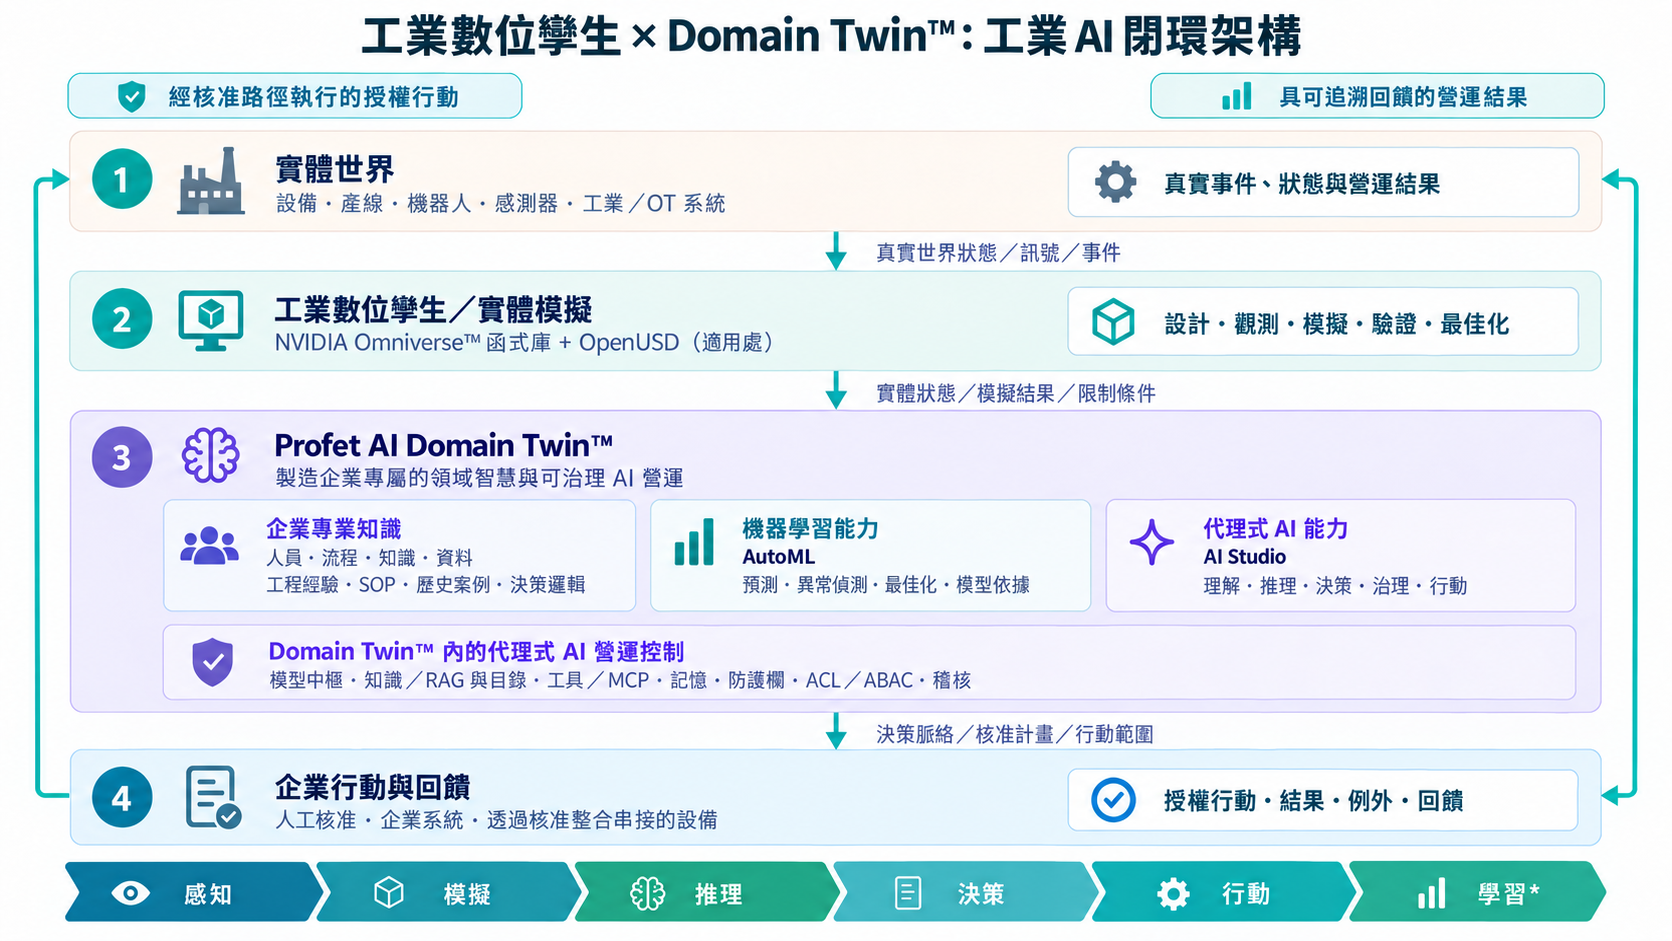
圖 1|互補式架構:實體世界與 Domain Twin™ 在同一個受治理閉環中交換狀態、限制條件、決策與營運回饋。Domain Twin™ 是產品層;AutoML 與 AI Studio 分別提供機器學習與代理式 AI 能力。
| 層次 | 技術角色 | 在閉環中的作用 |
|---|---|---|
| 1 · 實體世界 | 設備、產線、機器人、感測器與工業/OT 系統 | 產生事件、設備遙測、運轉狀態與執行結果。 |
| 2 · 工業數位孿生/實體模擬 | OpenUSD 場景資料,以及依情境使用的 NVIDIA Omniverse™ 技術 | 描述、模擬、驗證並最佳化實體環境、行為與物理限制。 |
| 3 · Profet AI Domain Twin™ | 企業專業知識(人員、流程、知識、資料);AutoML 機器學習能力;AI Studio 代理式 AI 能力,以及 Model Hub、Knowledge/RAG、Tools/MCP、Memory、Guardrails、ACL/ABAC、Audit | 把 know-how、模型證據、決策權與治理條件組成 AI 可使用的決策環境,並治理推理、授權與行動。 |
| 4 · 企業行動與回饋 | 人工核准、企業系統回寫,以及核准路徑下的設備回應 | 只執行已授權的步驟,並保留結果、例外與回饋,供稽核與後續改善。 |
表 2|四個相互作用的層次,將實體世界的證據接到企業判斷、授權與行動。
工程上最重要的,是先把「實體狀態」和「企業決策狀態」之間的介面定義清楚。設備 ID、線別/廠別階層、製程配方版本、批次與時間戳記必須先對齊,AI 代理才不會把不同事件的資料混在一起;模型輸出也必須帶著版本與適用範圍。推理與授權更要分開處理,因為能讀取資料,不代表有權修改系統。這些條件應該被做成可檢查、可測試的系統介面,而不是藏在一段大型語言模型(LLM)提示詞裡。
半導體設備異常:一個完整的決策閉環
以半導體工廠的設備異常為例。當設備遙測資料開始偏離預期範圍,數位孿生或其他實體世界資料/模擬層,可以提供設備狀態、周邊環境與物理限制;若具備模擬能力,也能先評估某項調整可能造成的影響。
但工程診斷通常才剛開始。工程師還可能需要同時比對設備警報、維修履歷、製程條件、目前使用的製程配方與關鍵參數、近期批次、過去故障案例、設備文件、品質資料、現行 SOP,以及分析工具或 AutoML 模型輸出。Domain Twin™ 內的代理式 AI 能力可以把這些來源放進同一個事件脈絡,調用核准的模型與工具、比對歷史案例,再依照企業既有的判斷方式往下處理。
接下來不是讓 AI 直接「給答案」,而是讓流程依序經過觀察、分析、建議、驗證、授權與執行。每一步都要帶著對應的證據、適用條件與責任邊界;執行結果再回到系統,成為下一輪可追溯的營運回饋。AI 可以更深入參與營運,但不會跳過企業原本的控制與責任機制。
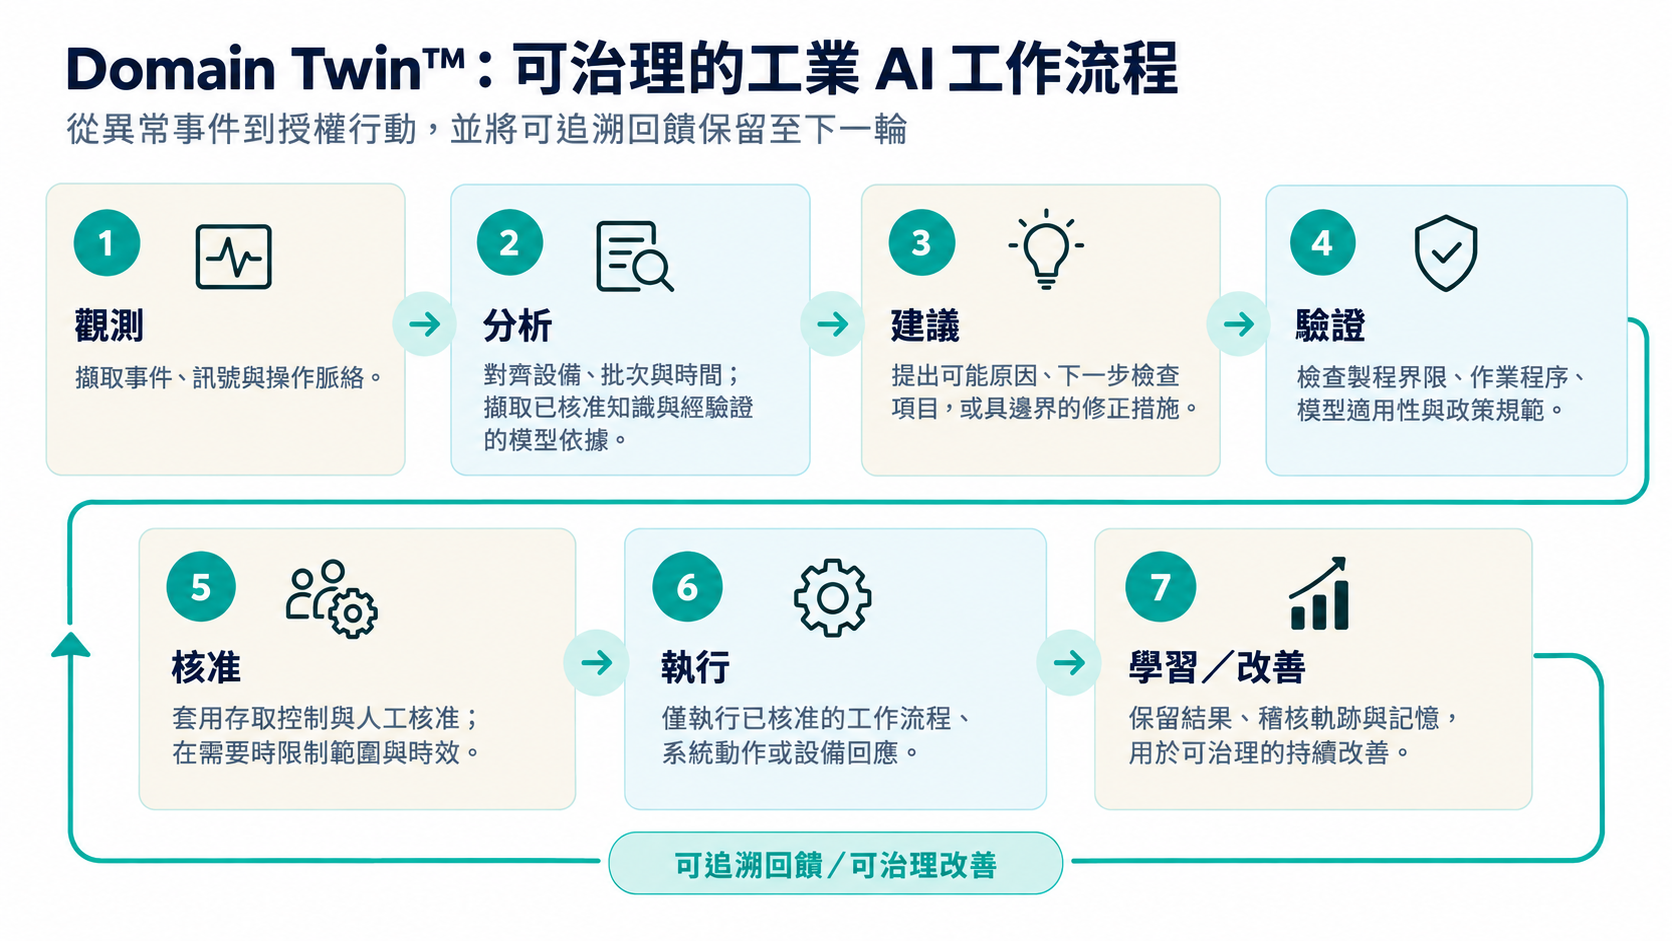
圖 2|Domain Twin™ 治理式工業 AI 工作流程:從異常訊號進入工程判斷,到授權執行與結果回收;每一步都有明確的證據與責任邊界。
| 步驟 | 工程行為 |
|---|---|
| 觀察 | 擷取異常事件、設備訊號與當下操作條件。 |
| 分析 | 對齊設備、批次與時間,調用歷史案例、SOP、工程知識與分析/AutoML 模型證據。 |
| 建議 | 提出可能原因、檢查順序,或有明確邊界的修正方案,並附上依據。 |
| 驗證 | 比對設備/製程限制、模型適用範圍、核准程序與企業政策。 |
| 授權 | 依 RBAC/ABAC、HITL 與限時授權條件,決定可執行範圍與有效期間。 |
| 執行 | 只在授權範圍內觸發核准工作流程、企業系統動作或設備回應。 |
| 回饋/改善 | 保存結果、稽核軌跡與記憶,供後續知識、模型與工作流程改善。 |
表 3|設備異常從工程判斷走到授權行動的工作流程。
治理必須直接進入執行流程
只要 AI 代理開始調用企業工具、回寫系統或影響設備,治理就不能停留在政策文件。RBAC/ABAC 用來限制代理可存取的模型、知識與工具;人工介入/核准(HITL)用來攔住高影響力操作;必要時,限時授權權杖還可以同時限制權限範圍與有效期間。每個關鍵步驟都應留下足夠紀錄,讓企業能回溯 AI 代理當時看見什麼、引用哪些知識與模型、由誰核准,以及最後發生什麼。
「學習」也不等於讓正式環境中的模型自行更新。營運結果可以被保存成回饋、記憶與新的企業知識;但模型重訓、知識更新與流程修改,仍應經過各自的驗證、版本管理與治理,再進入正式環境。
Domain Twin™ 與 NVIDIA 物理 AI 架構如何銜接
NVIDIA 以「三部電腦解決方案」描述物理 AI 的開發生命週期,涵蓋訓練、模擬,以及即時推論與控制:DGX 系統支援訓練;Omniverse 與 Cosmos 運行於 RTX PRO 伺服器,支援模擬;Jetson AGX 系統則負責邊緣端的即時推論與控制。NVIDIA 的工業數位孿生也已從設計與模擬延伸到營運與最佳化;2026 年發表的 Factory Operations Blueprint(FOX),則進一步把即時工廠資料、專用 AI 代理與機器納入工廠級協作。
NVIDIA 的能力愈往真實工廠營運延伸,製造企業自己的領域脈絡就愈重要。通用平台可以提供運算、模擬與 AI 代理協作,卻不會天然知道某家工廠誰擁有製程配方的決策權、哪一版 SOP 有效、模型在哪些條件下才能使用、哪一層級需要升級核准,以及現場有哪些例外規則。這些企業內部狀態必須被明確表示,Domain Twin™ 承接的就是這一層。
| 物理 AI 階段 | NVIDIA 主要能力 | Domain Twin™ 如何銜接 |
|---|---|---|
| 訓練/模型開發 | 以加速運算與資料建立、改善 AI 能力。 | 把已驗證的模型輸出納入企業知識與決策流程。 |
| 模擬/數位孿生 | 在部署前描述、測試並最佳化實體環境、行為與限制條件。 | 把設備狀態、模擬結果與物理限制帶進企業推理與決策。 |
| 推論/工廠營運 | 讓 AI 在接近實體系統的位置運行,並支援工廠級 AI 協作。 | 套用企業自己的 know-how、模型適用性、權限、核准條件與治理流程。 |
表 4|NVIDIA 物理 AI 與 Domain Twin™ 在工業 AI 生命週期中承接不同但相互銜接的責任。
閉環不是單向傳遞,而是雙向約束
完整的工業 AI 閉環,不是把數位孿生的結果單向丟給 AI 代理。實體世界與數位孿生提供即時狀態、模擬結果與物理限制;Domain Twin™ 則把企業目標、工程規則、模型適用性、資安政策與人工核准條件帶回規劃與執行。決策完成驗證與授權後,AI 代理才能把它轉成企業系統操作或核准的設備回應;最後,結果再回到 Domain Twin™,成為下一輪判斷可用的回饋、記憶與知識。
| 資訊流向 | 帶入的內容 |
|---|---|
| 實體世界/數位孿生 → Domain Twin™ | 設備狀態、遙測資料、模擬結果、物理限制與事件識別資訊 |
| Domain Twin™ → 規劃/AI 代理工作流程 | 企業目標、工程規則、SOP、模型證據、資安政策與人工核准條件 |
| AI 代理工作流程 → 企業/設備 | 建議行動、證據摘要、已授權參數與目標工具/系統 |
| 執行結果 → Domain Twin™ | 系統回應、例外、工程師回饋與營運結果,沉澱成可追溯的回饋、記憶與企業知識 |
表 5|只有當狀態、限制條件、授權與結果能雙向流動,工業 AI 才真正形成閉環。
Domain Twin™ 承接 NVIDIA 工業 AI 進入製造營運所需的領域層
NVIDIA 提供的是可以跨產業複用的橫向能力:加速運算、工業數位孿生、物理 AI,以及愈來愈完整的 AI 代理協作。真正進入工廠後,每一家製造企業仍有一套無法被通用平台預先寫好的「營運語意」:誰對製程配方負責、哪一版 SOP 有效、哪些歷史案例值得信任、模型在哪些條件下適用、核准矩陣怎麼走,以及同一套流程到了不同產品、產線、工廠或區域後要如何調整。這些條件如果沒有被軟體化,AI 就只能停留在單一場景裡做客製整合。
NVIDIA 的鴻海案例已經證明,標準化 OpenUSD 數位孿生資產可以讓整條產線的配置更容易跨廠移轉與複製。往下一層看,企業還需要回答另一個問題:產線移走之後,工程師怎麼判斷、哪些模型可以用、哪一版 SOP 生效、誰能核准,以及什麼情況必須升級處理,能不能一起被帶過去?這正是製造 know-how 能否真正「可攜」的關鍵。
Profet AI 以 Domain Twin™ 把這一層做成可運作的軟體能力。模型、AI 代理與實體系統不再各自帶著一套隱含規則,而是共同引用同一套企業情境、模型適用性、權責與治理邊界。當這些關係被明確表示後,企業就不必在每一個新應用、每一條產線重新把 know-how 從頭翻譯一次。
這也是 Domain Twin™ 在 NVIDIA 工業 AI 生態系中的價值:它不是另一套運算或模擬基礎,而是把 NVIDIA 的橫向能力接到製造企業自己的知識、模型、權限與流程,並沉澱成可治理、可稽核、可複用的 AI 資產。從單一 PoC 走向多線、多廠甚至跨區部署時,真正需要被複製的不是某一次 AI 代理對話,而是已驗證的判斷方法:相關知識、模型證據、操作規則、工作流程與治理邊界。這個領域層,決定同一套工業 AI 基礎能不能在不同場域被正確理解、授權與複用。
從更準的模擬,走向可複製的營運能力
工業數位孿生會持續提升物理精度、模擬效率與營運涵蓋範圍;AI 模型也會更強,設備與機器的自主程度會更高。但工廠真正怎麼運作,從來不只由物理定律決定,還取決於多年累積的工程經驗、製程知識、企業規則、資安政策與組織責任。當工業 AI 要從單點應用走向規模化,這些內容也必須有一套 AI 能使用、企業能治理,而且可以跨場域複用的表示方式。
當實體世界的數位孿生與企業專業知識的 Domain Twin™ 穩定接在一起,工業 AI 才真正具備從感知、模擬、推理、決策到授權行動的完整路徑;執行結果再回到下一輪,形成可追溯、可改善的營運閉環。
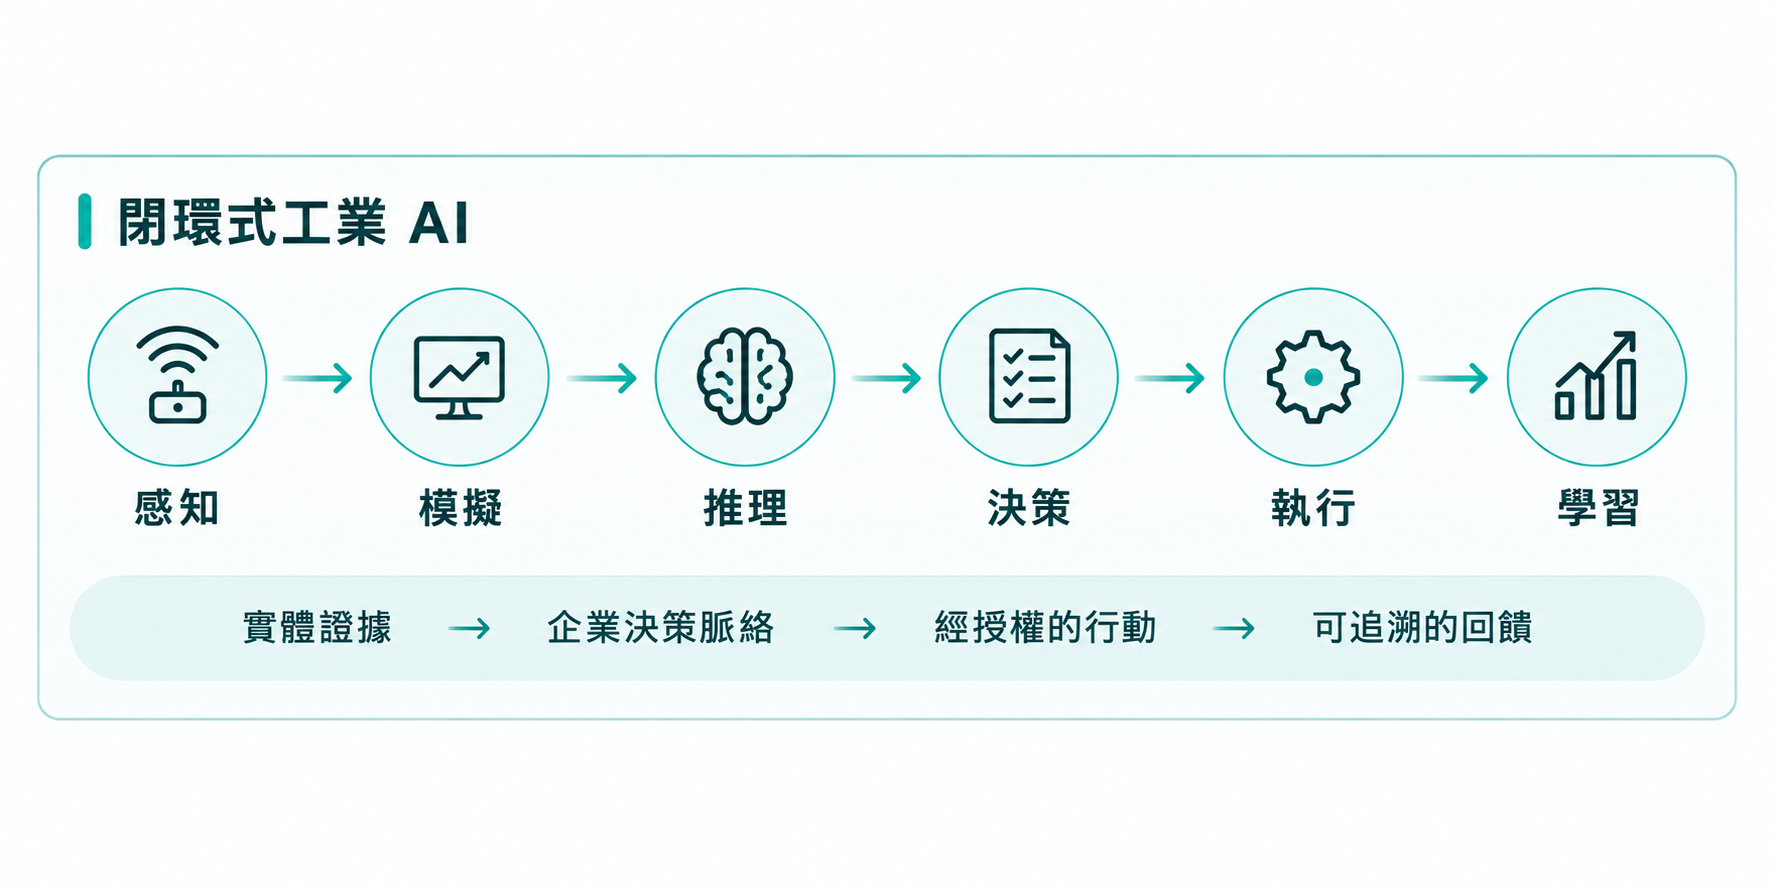
數位孿生讓物理 AI 更了解「工廠正在發生什麼」;Domain Twin™ 則讓企業 AI 知道「依照這家公司的知識、模型與規則,下一步能做什麼、誰可以做、做到哪裡」。兩者接起來,工業 AI 才能從單點能力變成可複製的營運系統,讓第一線 know-how 不再只跟著個人流動,而是成為可以跨產線、跨工廠持續使用的企業資產。
常見問題
Domain Twin™ 會取代工業數位孿生嗎?
不會。在本文架構中,工業數位孿生提供實體狀態、模擬結果與限制條件;Domain Twin™ 則加入製造企業特有的知識、模型證據、權限與工作流程,支援受治理的決策與行動。
AI 代理可以未經核准就改動設備設定嗎?
只有明確授權範圍內的動作才應被執行。製程限制、存取控制、必要的人工核准與稽核紀錄,共同界定「提出建議」與「實際操作設備或企業系統」之間的邊界。
探索 Domain Twin™ 如何進入製造工作流程
進一步了解 Domain Twin™、AutoML 與 AI Studio,盤點您的使用情境需要哪些知識、模型證據、系統連接與核准節點。